Den Code schreiben die Agenten. Was bleibt für mich?
Sechs Tage Montageanleitungs-App: Meine Arbeit steckt vor und zwischen dem Code, und ich erledige sie per Sprache.
Nach sechs Tagen habe ich am 27. September nachgezählt. Die App besteht aus 7.345 Zeilen Code und 9.449 Zeilen Tests. Die acht Umsetzungspläne, nach denen die Agenten sie gebaut haben, haben zusammen 23.566 Zeilen.

Ganz fair ist die Rechnung nicht, weil jeder Plan den Code und die Tests vollständig enthält. Dazu kommen aber Begründungen, Prüfschritte, erwartete Testergebnisse und die Entscheidungen, die vorher gefallen sind. Und vor dem ersten Plan stand ein Entwurf mit 1.042 Zeilen, ein Glossar und inzwischen neun Architekturentscheidungen.
Im ersten Teil habe ich erzählt, dass ich per Sprache programmiere. Wer dabei an Vibe Coding denkt, liegt bei diesem Projekt daneben. Den Code schreiben die Agenten. Meine Arbeit steckt davor und dazwischen.
Wie viel Zeit die Planung frisst
Bei meinen ersten, einfachen Programmen mit Agenten ging nach meiner Schätzung 30 bis 40 % der Zeit in die Planung. Beim Programmieren selbst kam damals wenig Rückmeldung, also musste vorher alles sitzen.
Bei größeren Projekten mit Prüfschleifen und Gegenchecks durch andere Modelle hat sich das verschoben. Die Planung liegt jetzt bei etwa 20 %. Dafür gibt es während der Umsetzung viel mehr Interaktion: Rückfragen, Befunde, Bestätigungsrunden. Der Code wird dabei besser.
Getippt habe ich in keiner der beiden Phasen. Die Planung besteht meistens aus längeren Gesprächen mit verschiedenen Modellen, in denen ich festlege, was das Programm können soll. Der Rest ist Entscheiden: Befund annehmen oder ablehnen, Rückfrage beantworten, am iPhone nachsehen.
Zuerst reden, dann entscheiden
Am Anfang stand ein Brainstorming mit dem Skill brainstorming aus den Superpowers-Skills. Der Skill fragt so lange nach Zweck, Nutzern und Grenzen, bis ein Entwurf entstehen kann. Daraus wurde ein Designdokument mit Architektur, Datenmodell, ERP-Anbindung, Word-Erzeugung und Testplan.
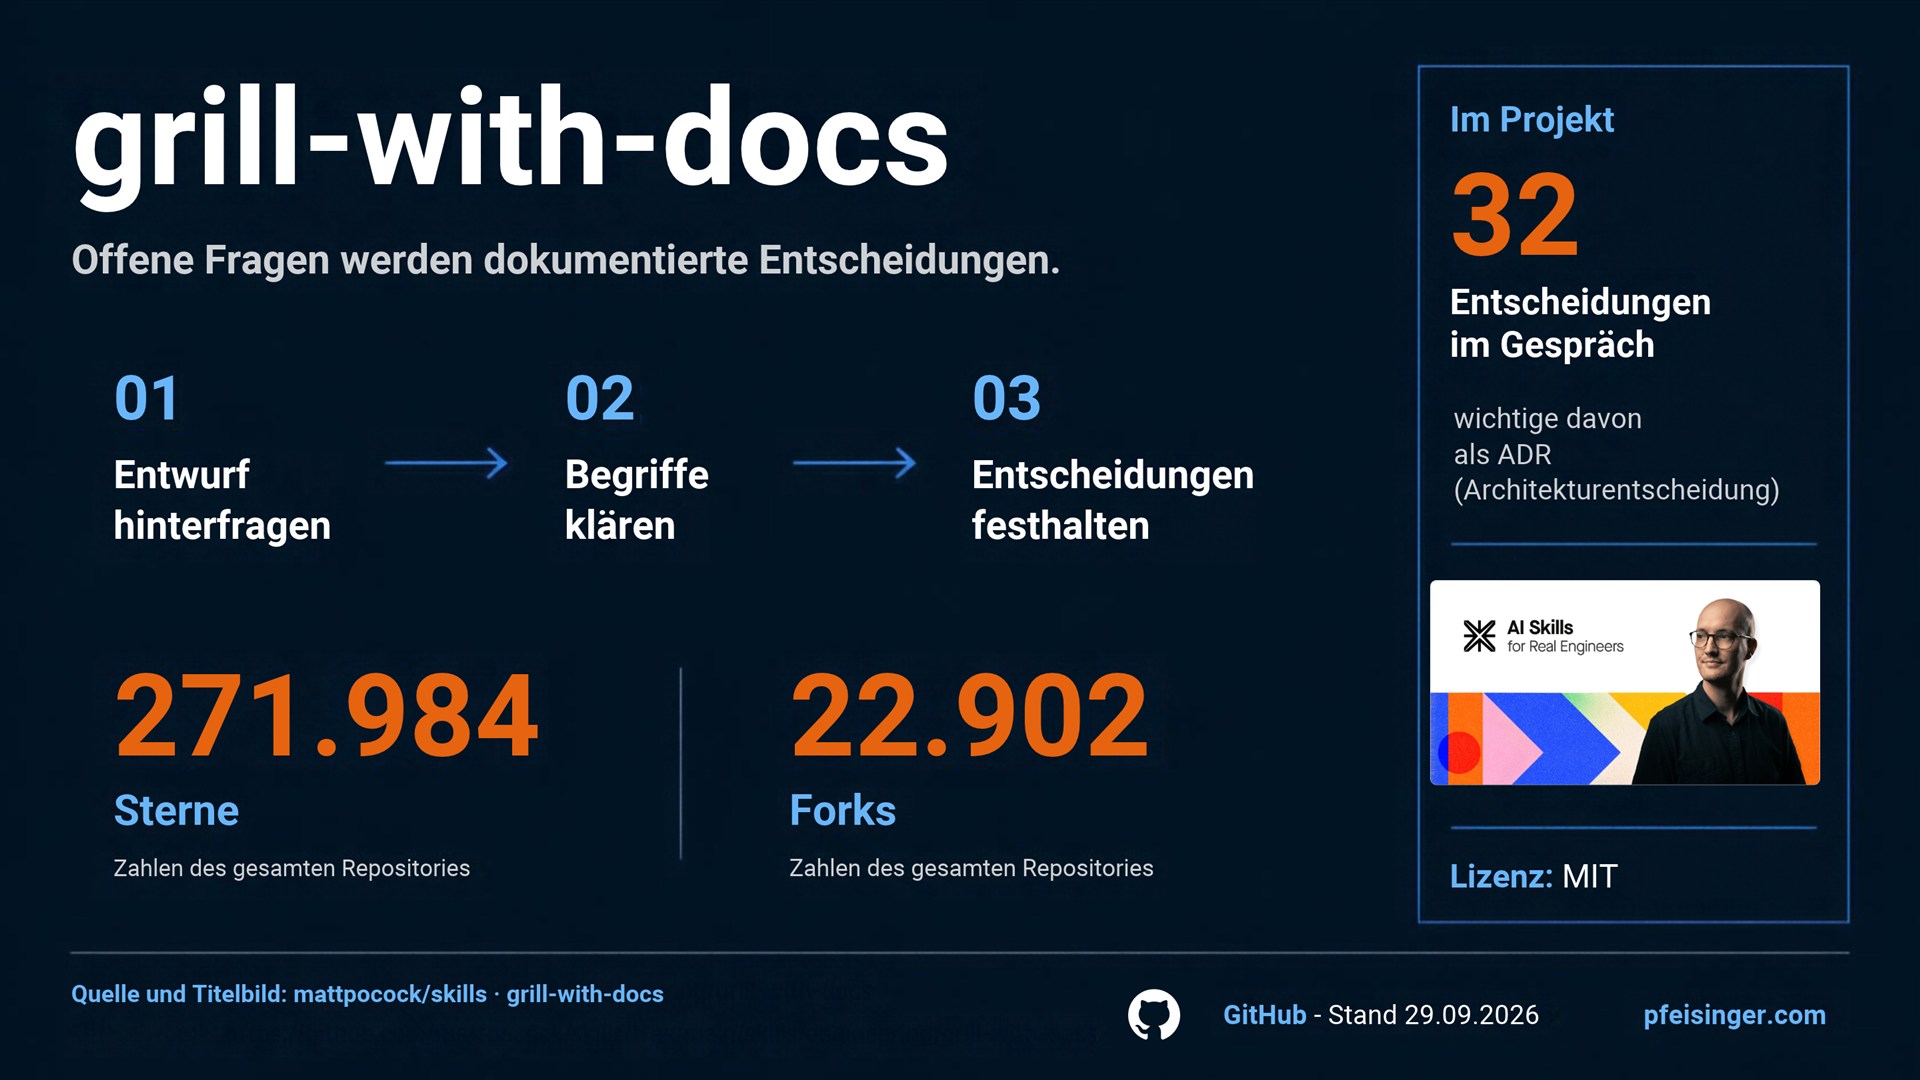
Dann habe ich mich grillen lassen. grill-with-docs geht jede offene Stelle des Entwurfs durch und fragt, bis eine Entscheidung steht. 32 Entscheidungen sind so zusammengekommen, alle im Gespräch. Die mit Tragweite landen als ADR im Repo, kurze Dokumente mit Kontext, Entscheidung und Folgen. Drei Tage später macht dann kein Agent dieselbe Frage wieder auf.
Ein Glossar für alle Agenten
Das Glossar legt fest, welches Wort was bedeutet, und es ist verbindlich: Montageanleitung, Arbeitsschritt, Rasterbild, Bildunterschrift. Ohne diese Liste erfindet jede Sitzung ihre eigenen Begriffe, und spätestens im Review reden zwei Modelle aneinander vorbei.
Zusammen mit der gemeinsamen AGENTS.md, die ich im ersten Teil beschrieben habe, ist das die Sprache, in der Claude und Codex über das Projekt reden.
Pläne, die schon gelaufen sind
Aus dem Entwurf macht writing-plans einzelne Umsetzungspläne. Jeder Plan liefert eigenständig lauffähige, getestete Software und enthält jede Datei und jede Änderung im Wortlaut, samt dem Test, der vorher rot und danach grün sein muss.
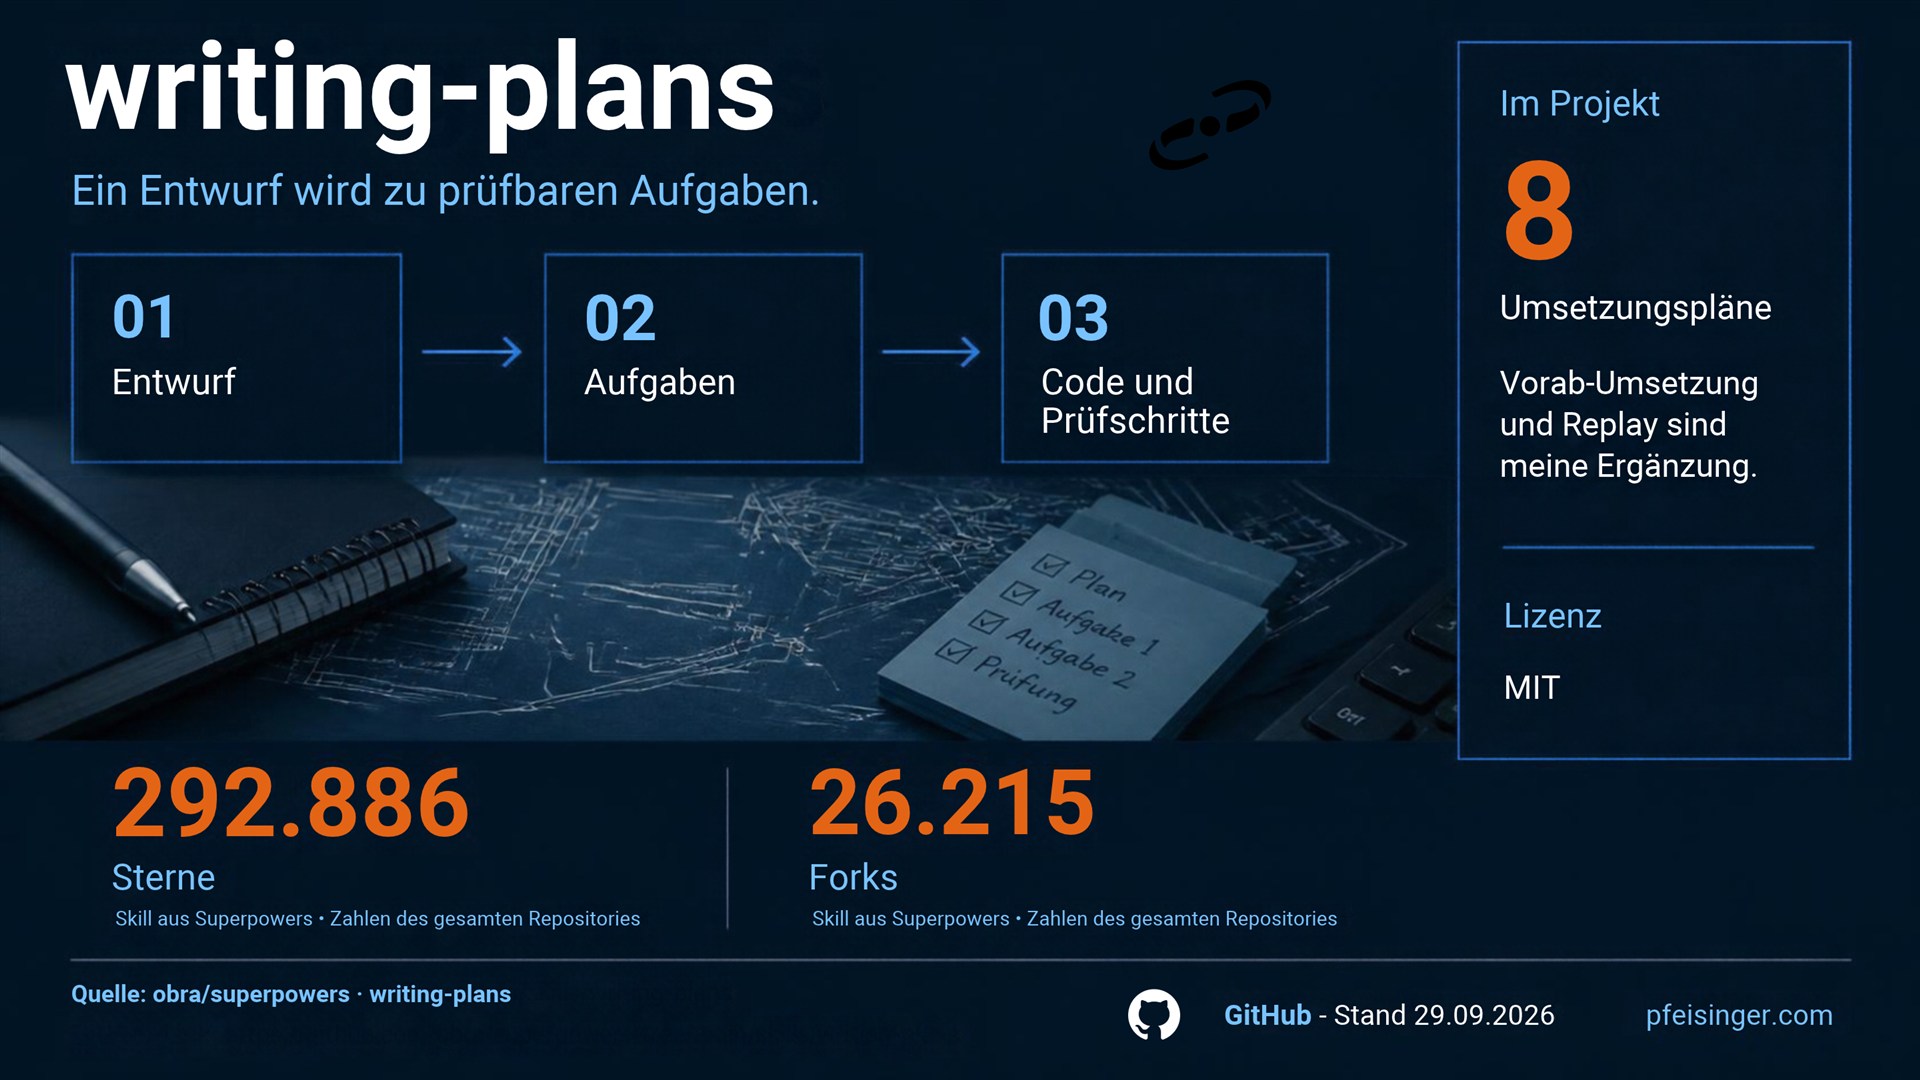
Ab dem vierten Plan habe ich die Reihenfolge umgedreht. Ein Agent setzt den Plan zuerst in einer Arbeitskopie komplett um, eine Aufgabe pro Commit. Ein Skript setzt aus diesen Commits den Plan zusammen, ein zweites spielt ihn von vorne nach und prüft Byte für Byte, ob derselbe Stand herauskommt. Codex prüft also einen Plan, dessen Code schon gelaufen ist.
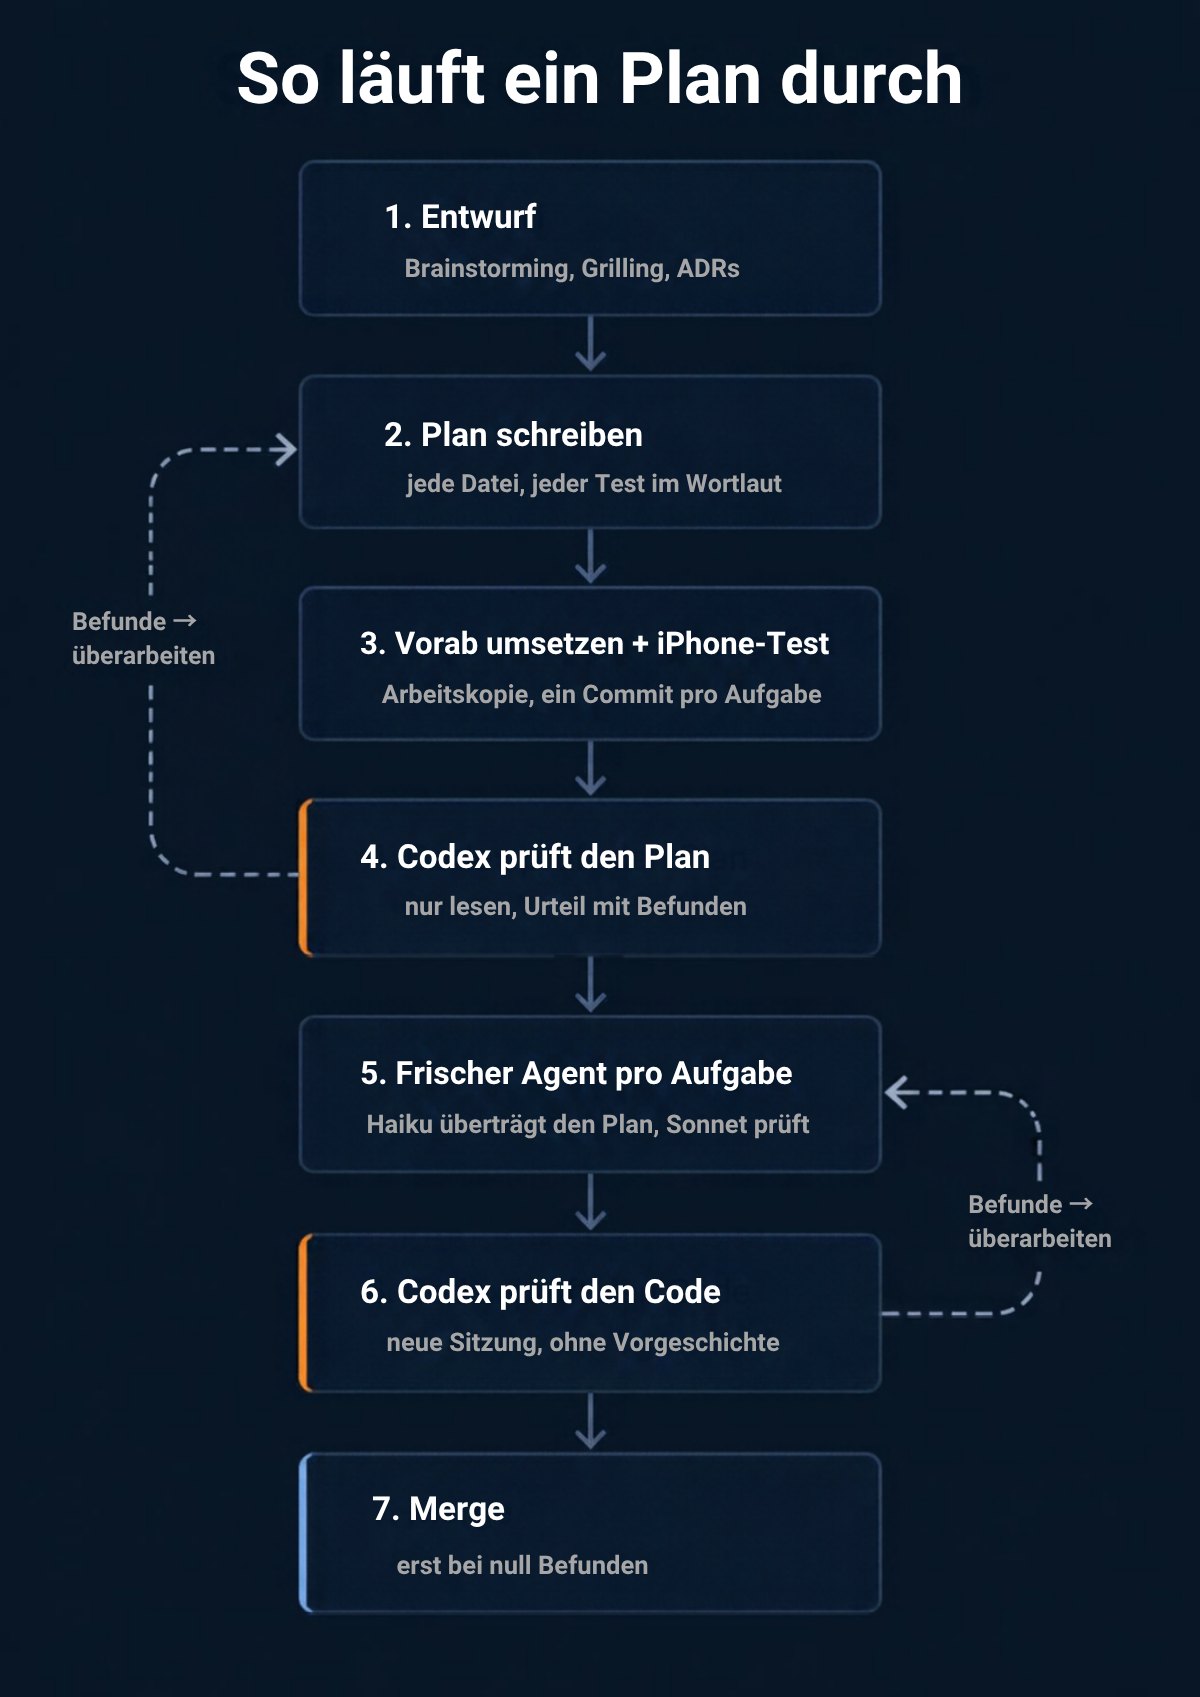
Seit dem Plan für die Oberfläche am Handy kommt noch ein Schritt dazu: Ich teste die Arbeitskopie am echten iPhone, bevor jemand den Plan prüft. Beim ersten Mal ist dabei eine Annahme aus dem Entwurf gefallen. Die Kamera, die Safari aus einem Upload-Feld öffnet, bietet kein quadratisches Format an. Der ganze Entwurf war davon ausgegangen.
Codex prüft, bevor gebaut wird
Jeder Plan geht an Codex, bevor gebaut wird. Der Skill claudex-loop übergibt ihn in einer Sitzung, die nur lesen darf, und bekommt ein strukturiertes Urteil zurück: freigegeben, überarbeiten oder blockiert, mit Befunden, Belegen und dem, was Codex tatsächlich angesehen hat. Wie oft Codex dabei etwas gefunden hat, zeige ich im dritten Teil.
Ein frischer Agent pro Aufgabe
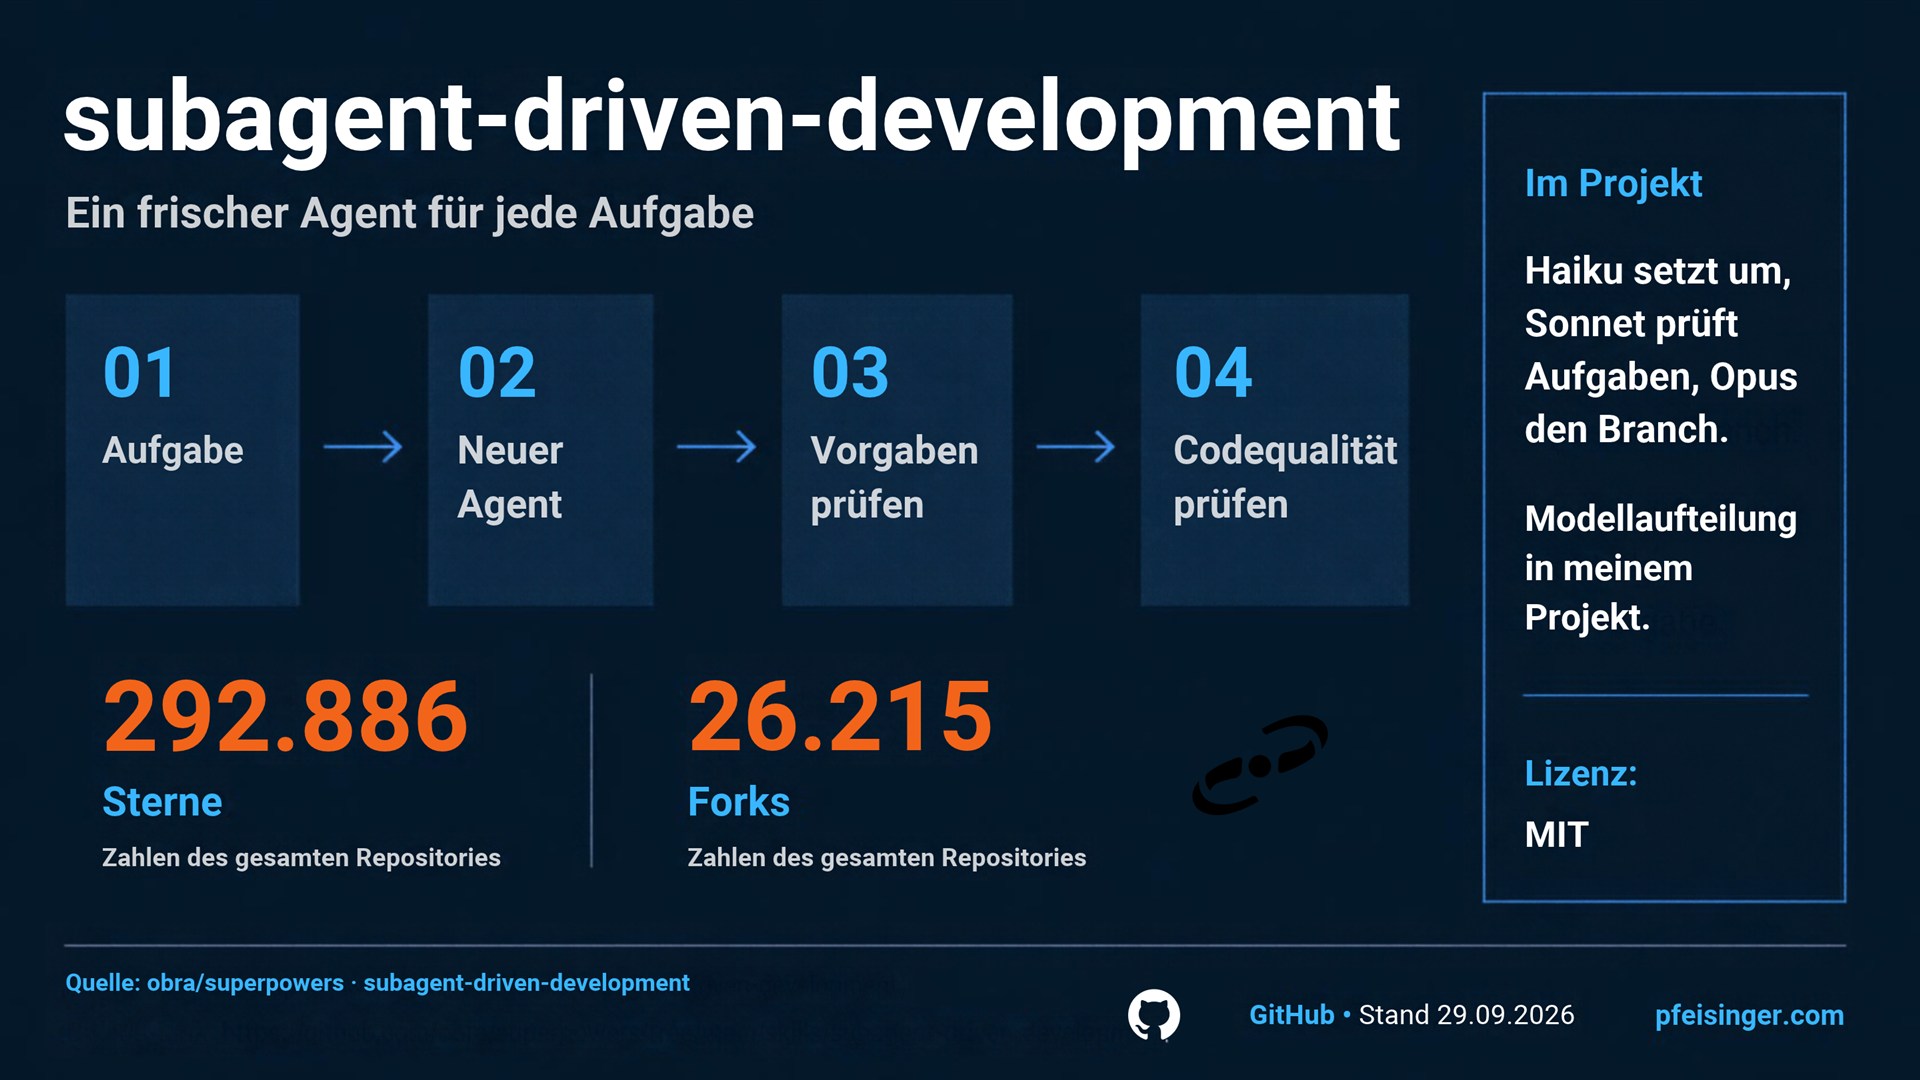
Gebaut haben die Agenten mit subagent-driven-development. Für jede Aufgabe startet ein neuer Subagent, der nur seinen Auftrag kennt. Danach prüft ein zweiter den Diff gegen den Auftrag, am Ende schaut ein dritter über den ganzen Branch.
Die Modelle wähle ich nach Aufgabe. Haiku setzt um, wo der Plan den Code vollständig vorgibt, Sonnet prüft die einzelnen Aufgaben, Opus macht das Abschlussreview. Jeden Konflikt zwischen Plan und Reviewer entscheide ich selbst und lasse die Entscheidung in ein Ledger schreiben. Bei Plan 1 waren das 22 solche Entscheidungen.
Den fertigen Code prüft Codex noch einmal, wieder in einer frischen Sitzung ohne Vorgeschichte.
Tests, die ihre Tests prüfen
Grüne Tests sagen noch nicht viel. Deshalb baut ein Skript absichtlich Fehler in den Code ein, einen nach dem anderen, und schaut, ob mindestens ein Test rot wird. Beim Werkzeugkatalog waren es 34 Mutationen, 32 wurden gefangen. Die zwei übrigen ändern nachweislich nichts am Verhalten. Eine dritte hatte vorher überlebt und dabei eine echte Lücke gezeigt, die jetzt ihren eigenen Test hat.
Was ich wieder weggelegt habe
Nicht jeder Skill hat sich gelohnt. Mit graphify habe ich aus Code und Doku einen Wissensgraphen gebaut, 1.673 Knoten in 69 Gruppen. Die Agenten brauchten für einen einzelnen großen Plan aber 9 bis 16 Minuten, und ich habe den Lauf abgebrochen, bevor alle Pläne drin waren. Seither ist der Graph pausiert und kommt nur noch auf Zuruf zum Einsatz.
Das nächste Projekt startet mit SpecKit
Nebenbei habe ich mit SpecKit von GitHub herumprobiert. Es geht denselben Weg in fester Form: einmal pro Projekt eine Verfassung mit den Grundregeln, dann pro Feature Spezifikation, Plan, Aufgaben, Umsetzung.
Mein nächstes Projekt starte ich damit, wieder per Sprache. Ob SpecKit sich mit den Superpowers-Skills verträgt oder ihnen in die Quere kommt, sehe ich spätestens beim ersten Plan.